双视角世界模型扩散 Transformer 架构图(可编辑 PPT)
概览
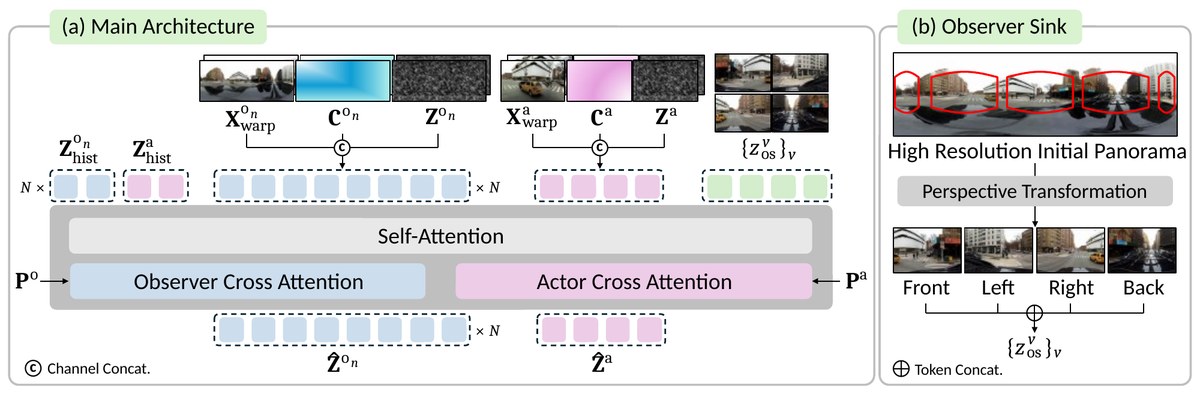
这张可编辑的 PowerPoint 架构图展示了一个用于持续世界建模的双视角(主体与观察者)视频扩散 Transformer。图稿依据 CC BY 4.0 许可,改编自论文原图。
图中内容
面板 (a) 中,变换后的帧、条件图和带噪潜变量通过通道拼接,融合成蓝色和粉色两条 token 序列,另有历史 token 和绿色的汇聚(sink)token。它们一起送入共享模块:模块内有自注意力,以及分别由相机位姿 Po 和 Pa 驱动的观察者交叉注意力与主体交叉注意力,最终输出去噪结果 Ẑ。面板 (b) 展示一张高分辨率全景图经过透视变换,得到前、左、右、后四个视图,再拼接成汇聚 token。面板、注意力模块、token 单元、虚线 token 分组、连接线、ⓒ/⊕ 运算符和数学标注都是原生形状,可以直接改成你需要的样式。
文件格式
下载文件为单页 .pptx,尺寸 11.11 × 3.65 英寸,可在 PowerPoint、Keynote、WPS 和 LibreOffice Impress 中打开。Google 幻灯片也能打开,但版式可能会有细微偏移。另附全分辨率的 preview.png 和一张 1200 px 宽的网页预览图。
形状与编辑
文件共含 167 个元素:146 个原生可编辑形状(53 个自选图形、69 个文本框、19 条线条或连接符、5 条自由曲线)和 21 张嵌入位图。数学标注已经分组,每个标注可以整体移动。所有文字和数学标注(Zhist、Xwarp、C、Z、P、Ẑ、{zvos}v)都能编辑,面板边框和标签、注意力模块、每个 token 单元和虚线分组、拼接运算符、箭头,以及全景图上的红色视场框也都可以修改。
嵌入图片与字体
21 张嵌入的 PNG 图片包括:面板 (a) 中的 12 张堆叠缩略图(变换后的帧、青色和粉色条件图以及噪声潜变量,每种都分成前后两张卡片)、2×2 的汇聚视图缩略图,以及面板 (b) 中的 4 张透视视图和全景图。全景图上的红色框已从像素中去除,并以原生自由曲线重新绘制在上方。这些 PNG 保持原图分辨率(小缩略图,约每英寸 100 像素),如需大幅打印,建议换成你自己的图片。标签文字使用 Calibri,数学部分使用 Cambria,少数帽子符号使用 DejaVu Serif。缺少的字体会被替换,个别数学标注可能需要微调位置。数学上下标由定位文本框和文字拼成,并不是公式对象。这是为方便复用而忠实重绘的版本,并非论文作者的原始源文件。
来源与许可 改编自论文 World Observer: Joint Actor-Observer Generation for Persistent World Modeling 中的图 4,作者:Hyunwook Choi, Dahyun Chung, Hyunsung Kim, Siyoon Jin, Jinhyeok Choi, Junyoung Seo, Seungryong Kim(arXiv:2610.02162,https://arxiv.org/abs/2610.02162;代码:https://github.com/cvlab-kaist/world-observer)。原图采用 CC BY 4.0 许可(https://creativecommons.org/licenses/by/4.0/)。我们将其转换为可编辑的 PowerPoint 形状;修改者:叫我Alonzo就好了/alonzolab。本作品未获原作者认可或背书。再次使用这张图时,请保留署名(见 LICENSE-ATTRIBUTION.txt)。