视频大模型 Token 预算分配与选择架构图
概览
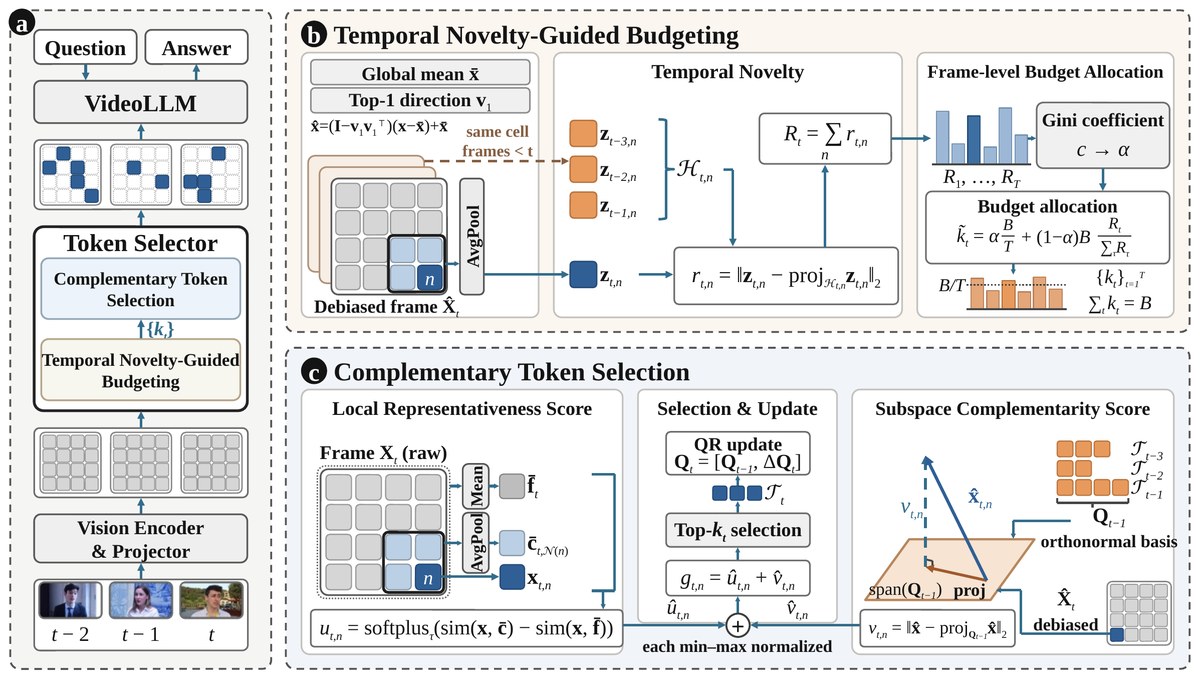
面向视频大模型、无需训练的视觉 token 选择三面板架构图。这是一张可编辑的 PowerPoint 图,依据 CC BY 4.0 许可改编自论文原图。
图中内容
(a) 总流程:t−2、t−1、t 三帧 → 视觉编码器与投影层 → 每帧 token 网格 → token 选择模块(时间新颖度引导的预算分配给出每帧预算 {k_t},再做互补 token 选择)→ 保留后的 token 网格 → VideoLLM → 问题 / 答案。(b) 时间新颖度引导的预算分配:去偏帧 x̂ = (I − v₁v₁ᵀ)(x − x̄) + x̄、AvgPool、与历史帧同位置格子的残差 r_{t,n}、帧级新颖度 R_t、Gini 系数映射到 α 以及预算公式 k̃_t。(c) 互补 token 选择:局部代表性分数 u_{t,n}(均值 / AvgPool 邻域 + softplus)、子空间互补性分数 v_{t,n}(向 span(Q_{t−1}) 正交基投影)、相加得到 g_{t,n}、top-k_t 选择,以及 Q_t 的 QR 更新。每个方框、箭头、标签和公式都是原生形状,改配色、改文字、拆开单独用都行,适合组会汇报、开题、论文配图和海报。
文件格式
下载包含:.pptx(1 页,13.30 × 7.54 英寸;PowerPoint、Keynote、WPS、LibreOffice 都能打开;Google Slides 也能用,但复杂自由曲线可能略有偏移)、.svg、.drawio。附原尺寸预览图 preview.png,另有 1200 px 网页预览图。
形状与编辑
342 个原生可编辑形状:230 个自选图形、58 个文本框、1 个自由曲线、53 条线条/连接线。另有 3 张嵌入图片(见下方说明)。可编辑内容:全部文字和公式(x̂ = (I − v₁v₁ᵀ)(x − x̄) + x̄、带投影范数的 r_{t,n}、R_t = Σ_n r_{t,n}、k̃_t 预算分式、u_{t,n}、v_{t,n}、g_{t,n}、Q_t = [Q_{t−1}, ΔQ_t]、ℋ_{t,n}、𝒯_t)、每个 token 格子和帧网格、叠放的去偏帧、柱状图、倾斜的子空间平面和投影向量、a / b / c 面板标号、虚线面板和所有箭头。
嵌入图片与字体
有 3 处是嵌入位图:t−2、t−1、t 三张示例视频帧缩略图,分辨率与原图相同,大幅打印时建议换成自己的图片。文字统一用 Times New Roman(Windows 和 macOS 自带;LibreOffice 会用等宽度的 Liberation Serif 显示)。𝒩、ℰ、𝒮 这类花体数学字母用 Cambria Math(随 Microsoft Office 安装),其他软件会自动换成数学字体。上下标是真正的上标 / 下标文字格式,不是公式编辑器对象。SVG 里的文字仍是可编辑文字;draw.io 文件是逐个形状转换的,个别位置可能要微调。本文件是忠实重绘,不是作者的原始源文件。
来源与许可 改编自论文 GleanVID: Complementary Token Selection for Efficient Video Large Language Models 的图 2,作者 Shuo Yang, Changbai Li, Rui Tang, Xinyu Zhao, Linlin Yang, Baochang Zhang(arXiv:2609.37042,https://arxiv.org/abs/2609.37042)。原图采用 CC BY 4.0 许可(https://creativecommons.org/licenses/by/4.0/)。由 叫我Alonzo就好了/alonzolab 重绘为可编辑形状并做了修改。本商品与原作者无关,也未获原作者认可。公开发布或分享这张图时,需要注明原论文出处;准确的署名文字在每个下载包里的 LICENSE-ATTRIBUTION.txt 中。
有疑问或反馈?请发邮件至 [email protected]