视觉语言模型测试时采样似然地形示意图
概览
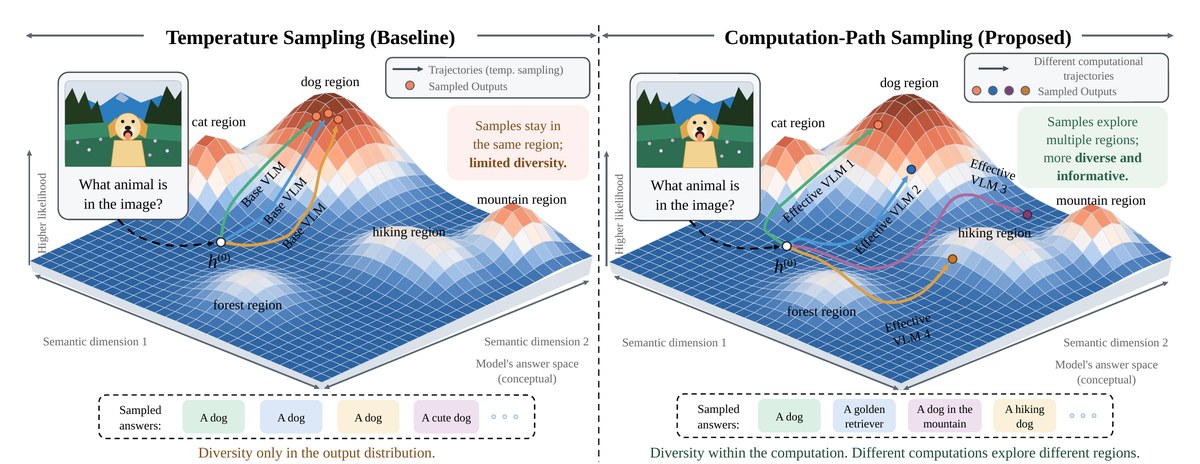
视觉语言模型在测试时获得多样答案的两种方式的左右对照概念图。这是一张可编辑的 PowerPoint 图,依据 CC BY 4.0 许可改编自论文原图。
图中内容
每一半都是一张三维似然地形(语义维度 1 / 2 上的着色四边形网格曲面,另有"似然更高"纵轴),几个峰分别标为 dog、cat、mountain、hiking、forest 区域;图片问答卡片("What animal is in the image?")经虚线箭头接到起点状态 h(0)。温度采样(基线):三条 "Base VLM" 轨迹都爬上同一个 dog 峰,图例标出轨迹和采样输出,浅珊瑚色提示框说明样本停在同一区域,底部答案条为 A dog / A dog / A dog / A cute dog。计算路径采样(本方法):四条不同颜色的 "Effective VLM 1–4" 轨迹落在不同的峰上并带彩色输出圆点,绿色提示框说明样本探索了多个区域,答案条为 A dog / A golden retriever / A dog in the mountain / A hiking dog。顶部标题箭头、中间虚线分隔和每一半下方的一句结论组成完整对照。每个方框、箭头、标签和公式都是原生形状,改配色、改文字、拆开单独用都行,适合组会汇报、开题、论文配图和海报。
文件格式
下载包含:.pptx(1 页,15.26 × 5.90 英寸;PowerPoint、Keynote、WPS、LibreOffice 都能打开;Google Slides 也能用,但复杂自由曲线可能略有偏移)、.svg、.drawio。附原尺寸预览图 preview.png,另有 1200 px 网页预览图。
形状与编辑
1748 个原生可编辑形状:64 个自选图形、49 个文本框、1622 个自由曲线、13 条线条/连接线(另有 4 个小编组)。不含任何嵌入图片,全部矢量。可编辑内容:全部文字和公式(h(0))、两张似然曲面的每个四边形网格面和底部阴影、坐标轴箭头和标签、区域标签、图片问答卡片及其示意照片、虚线输入箭头、每条轨迹曲线及其箭头和标签、起点和输出圆点、两个图例、两个提示框、采样答案小块和虚线答案条、顶部标题箭头、中间分隔线和结论句。
嵌入图片与字体
本文件不含任何嵌入图片,全部为矢量。每张似然曲面都是由很多小四边形自由曲线拼成的原生网格(每张 784 块),可以作为矢量改色、缩放,但逐块编辑会比较繁琐;每张曲面都已编组,可一次整体移动或缩放。问答卡片里的照片是用天空、山脊、树、草地和卡通小狗色块拼的扁平矢量示意图,不是论文里的照片;需要真实图片时直接把自己的图盖上去即可。正文和公式统一用 Times New Roman(Windows 和 macOS 自带;LibreOffice 会用等宽度的 Liberation Serif 显示)。上下标是真正的上标 / 下标文字格式,不是公式编辑器对象。SVG 里的文字仍是可编辑文字;draw.io 文件是逐个形状转换的,个别位置可能要微调。本文件是忠实重绘,不是作者的原始源文件。
来源与许可 改编自论文 Architectural Sampling: Test-Time Scaling via Computational Diversity in Frozen Vision-Language Models 的图 1,作者 Akshit Singh, Shyam Marjit, Wei Lin, Leonid Karlinsky, M. Jehanzeb Mirza(arXiv:2610.01687,https://arxiv.org/abs/2610.01687)。原图采用 CC BY 4.0 许可(https://creativecommons.org/licenses/by/4.0/)。由 叫我Alonzo就好了/alonzolab 重绘为可编辑形状并做了修改。本商品与原作者无关,也未获原作者认可。
有疑问或反馈?请发邮件至 [email protected]